අපි හැමෝම අද AI ගැන කතා කළාට, මේ හැමදේකම පටන්ගත්තෙ කොතනින්ද කියලා ඔයා කවදාහරි හිතලා තියෙනවද? අද අපි කතා කරන්න යන්නේ AI වල හදවත වන Neural Networks වල ආරම්භයේ ඉඳන්ම කතාවයි. ඒ කියන්නේ සරල Perceptron එකක ඉඳන් Multi-Layer Perceptron (MLP) එකක් දක්වා AI එකක් දියුණු වුණු හැටි .
මිනිස් මොළයෙන් පරිගණකයට (Biological Inspiration)
පරිගණකයකට හිතන්න පුරුදු කරන්න කලින්, විද්යාඥයන්ට ඕන වුණේ අපේ මොළය වැඩ කරන්නේ කොහොමද කියලා තේරුම් ගන්නයි. අපේ මොළයේ තියෙනවා නියුරෝන (Biological Neurons) බිලියන ගණනක්. මේවා එකිනෙකට සම්බන්ධ වෙලා තමයි අපි හිතන දේවල්, කරන දේවල් පාලනය කරන්නේ.
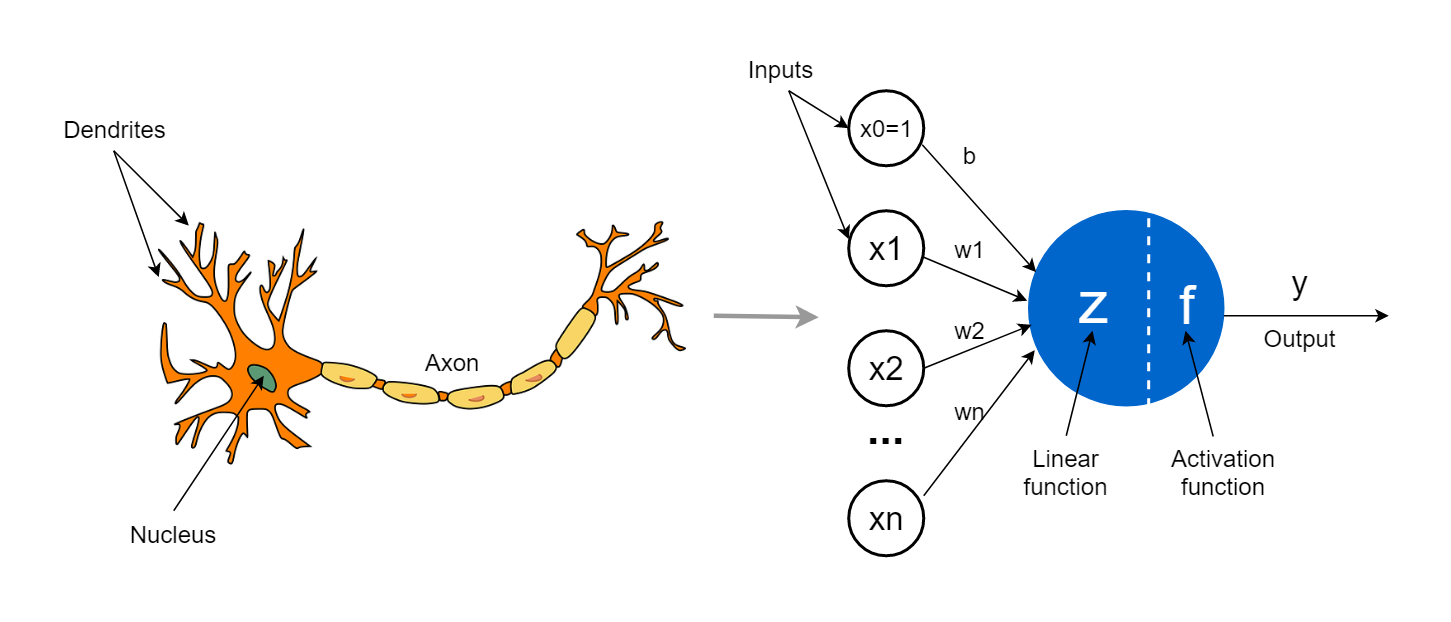
මේ සංකල්පය පදනම් කරගෙන තමයි 1958 දී Frank Rosenblatt කියන විද්යාඥයා විසින් ලොව පළමු කෘත්රිම නියුරෝනය වෙන Perceptron එක හඳුන්වා දුන්නේ. ඇත්තටම ජීව විද්යාත්මක නියුරෝනයක් කෘත්රිම නියුරෝනයකට සමාන වෙන්නේ මෙහෙමයි
- Dendrite = කෘත්රිම නියුරෝනයට දත්ත ලබාදෙන (Inputs) මාර්ගය.
- Cell Body = ලැබෙන දත්ත එකතු කරලා ගණනය කරන තැන (Summation).
- Axon = අවසාන තීරණය පිටතට දෙන මාර්ගය (Output).
Perceptron එකක් ගණනය කිරීම් කරන්නේ කොහොමද?
කෘත්රිම නියුරෝනයක් ඇතුළේ ඇත්තටම වෙන්නේ සරල ගණිත කර්මයක්. මේක තේරුම් ගන්න අපි ප්රධාන කොටස් 3ක් බලමු
- Inputs $$(x_1, x_2)$$අපි නියුරෝනයට ලබා දෙන දත්ත. (උදාහරණයක් විදිහට ගෙදරක වර්ග අඩිය සහ කාමර ගණන).
- Weights $$w_1, w_2$$ලැබෙන එක් එක් දත්තයට තියෙන වැදගත්කම (Strength). ගෙදරක මිල තීරණය කරද්දී කාමර ගණනට වඩා වර්ග අඩිය වැදගත් නම් ඒකේ weight එක වැඩියි.
- Bias $$b$$තීරණයක් ගැනීමට අවශ්ය මූලික එළිපත්ත (Threshold). මේක හරියට කිසිම input එකක් නැති වුණත් තියෙන base value එක වගේ.
මේ ඔක්කොම එකතු වුණාම හැදෙන මූලික සමීකරණය තමයි
The XOR Problem & AI Winter
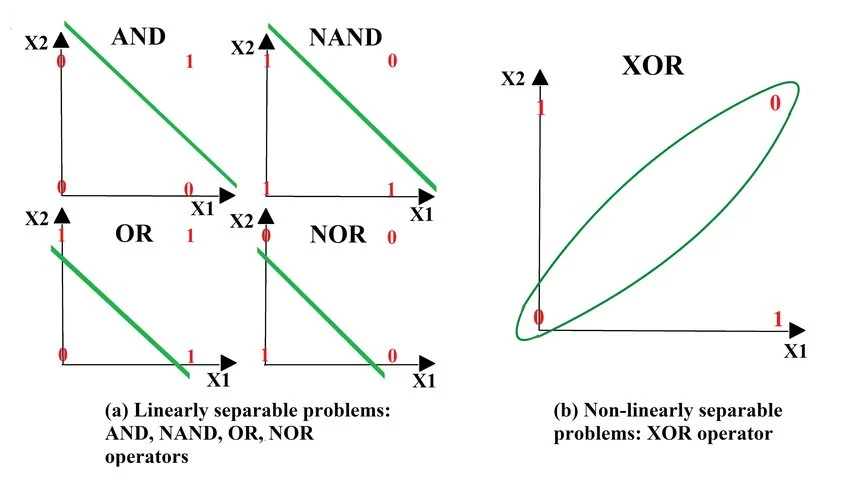
Perceptron එක මුලින්ම ආපු කාලේ හැමෝම හිතුවේ මේකෙන් ලෝකේ පෙරළන්න පුළුවන් වෙයි කියලා. සරල Logic Gates වෙන AND, OR, NAND, NOR වගේ දේවල් තනි සරල රේඛාවකින් වෙන් කරන්න (Linear Separability) මේකට පුළුවන් වුණා.
හැබැයි මේකේ ලොකු සීමාවක් තිබුණා. ඒ තමයි XOR ගේට්ටුව. XOR ගේට්ටුවේ ප්රතිදානයන් තනි සරල රේඛාවකින් කවදාවත්ම වෙන් කරන්න බැහැ. 1969 දී Marvin Minsky සහ Seymour Papert කියන පර්යේෂකයන් දෙන්නා පොතක් ලියලා මුළු ලෝකෙටම පෙන්නලා දුන්නා "මේ Perceptron එකකට XOR වගේ සරල දෙයක්වත් කරගන්න බැහැ" කියලා.
 Source Image
Multi-Layer Perceptron (MLP)
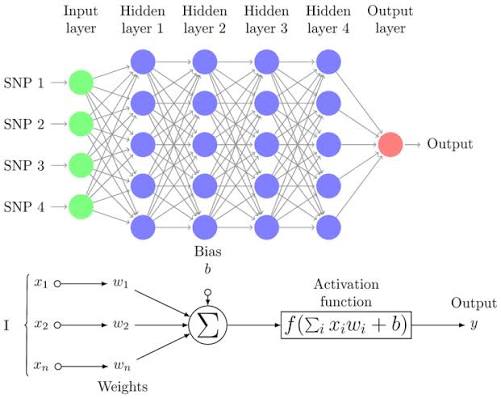
AI Winter එකෙන් ගොඩ එන්න විද්යාඥයෝ අපූරු විසඳුමක් ගෙනාවා. ඒ තමයි තනි නියුරෝනයක් පාවිච්චි කරනවා වෙනුවට, නියුරෝන කිහිපයක් ස්ථර (Layers) විදිහට එකතු කරන එක. මේකට කිව්වා Multi-Layer Perceptron (MLP) කියලා.
මේකේ ප්රධාන ස්ථර 3ක් තියෙනවා
- Input Layer: මුල් දත්ත ලබා ගන්නා ස්ථරය.
- Hidden Layer(s): දත්තවල ඇති සංකීර්ණ රටා හඳුනා ගන්නා රහසිගත ස්ථරය.
- Output Layer: අවසාන තීරණය ලබා දෙන ස්ථරය.
මේ විදිහට Hidden Layer එකක් එකතු කළාම ඒකට ඕනෑම සංකීර්ණ ගණිතමය Function එකක් ඉගෙන ගන්න පුළුවන් හැකියාව ලැබුණා. මේකට ගණිතයේදී කියන්නේ Universal Approximation Theorem කියලයි. ඒ කියන්නේ අර කලින් බැහැයි කියපු XOR ගැටළුව වගේ ඕනෑම සංකීර්ණ දෙයක් දැන් මේකට විසඳන්න පුළුවන්!
Activation Functions
Layer කීයක් තිබුණත්, අපි Activation Function එකක් පාවිච්චි කළේ නැත්නම් මුළු නියුරල් ජාලයම නිකන්ම නිකන් සරල Linear සමීකරණයක් (තනි සරල රේඛාවක්) බවට පත් වෙනවා. ඒ නිසා නියුරෝනයකට පණ දීලා සංකීර්ණ දේවල් හිතන්න පුරුදු කරන්නේ Activation Functions හරහායි.
භාවිතා වෙන ප්රධාන වර්ග කිහිපයක් මෙන්න
- Sigmoid: ලැබෙන Output එක 0 සහ 1 අතර අගයකට සීමා කරනවා.
- ReLU (Rectified Linear Unit) $$f(z) = \max(0, z)$$— මේක තමයි නූතන AI (Deep Learning) වල බහුලවම භාවිත වන වේගවත්ම ක්රමය. සෘණ අගයක් ආවොත් 0 කරනවා, ධන අගයක් ආවොත් ඒකම එළියට දෙනවා.
- Softmax: Multi-class classification (බළලෙක්ද, බල්ලෙක්ද, කුරුල්ලෙක්ද වගේ තෝරාගැනීම් කිහිපයක්) වලදී එක එක දේට අදාළ සම්භාවිතාව (Probability %) ලබා ගන්න පාවිච්චි කරනවා.
Forward Propagation සහ Loss Function
අපි දත්තයක් Input එකෙන් දුන්නාම, ඒක Weights, Biases සහ Activation Functions ඔක්කොම පහු කරගෙන Output එක දක්වා ගලාගෙන යන ක්රියාවලියට කියන්නේ Forward Propagation කියලයි. හැබැයි මුලදී කවදාවත් AI එක හරියටම උත්තරේ දෙන්නේ නැහැ. ලැබුණු Output එක සහ ඇත්තම සැබෑ පිළිතුර (Ground Truth) අතර තියෙන වෙනස කොච්චරද කියලා මනින්න අපි පාවිච්චි කරනවා Loss Function එකක්. (උදාහරණයක් විදිහට Mean Squared Error හෝ Cross-Entropy). ආරම්භයේදී Weights වල තියෙන්නේ random අගයන් නිසා නියුරල් ජාලය දෙන පිළිතුරු ගොඩක් වෙලාවට වැරදියි. ඒ නිසා මුලදී Loss එක ඉතා විශාල අගයක් ගන්නවා.
Conclusion
අද අපි තනි Perceptron එකක් වැඩ කරන විදිහේ ඉඳන්, AI Winter එකට හේතු වුණු XOR ගැටලුව සහ ඊට පස්සේ Multi-Layer Perceptron (MLP) එකක් හරහා ඒක විසඳගත්ත හැටි කතා කළා. හැබැයි දැන් ඔයාට ලොකු ප්රශ්නයක් එන්න ඕනේ... 🤔 නියුරල් ජාලය තමන් කරපු වැරැද්ද (Loss එක) බලාගෙන, තමන්ගේ Weights තනියම වෙනස් කරගෙන, හරියටම උත්තරේ දෙන්න තනියම හැදෙන්නේ (Learn කරන්නේ) කොහොමද? Part 2 - Backpropagation සහ Gradient Descent.