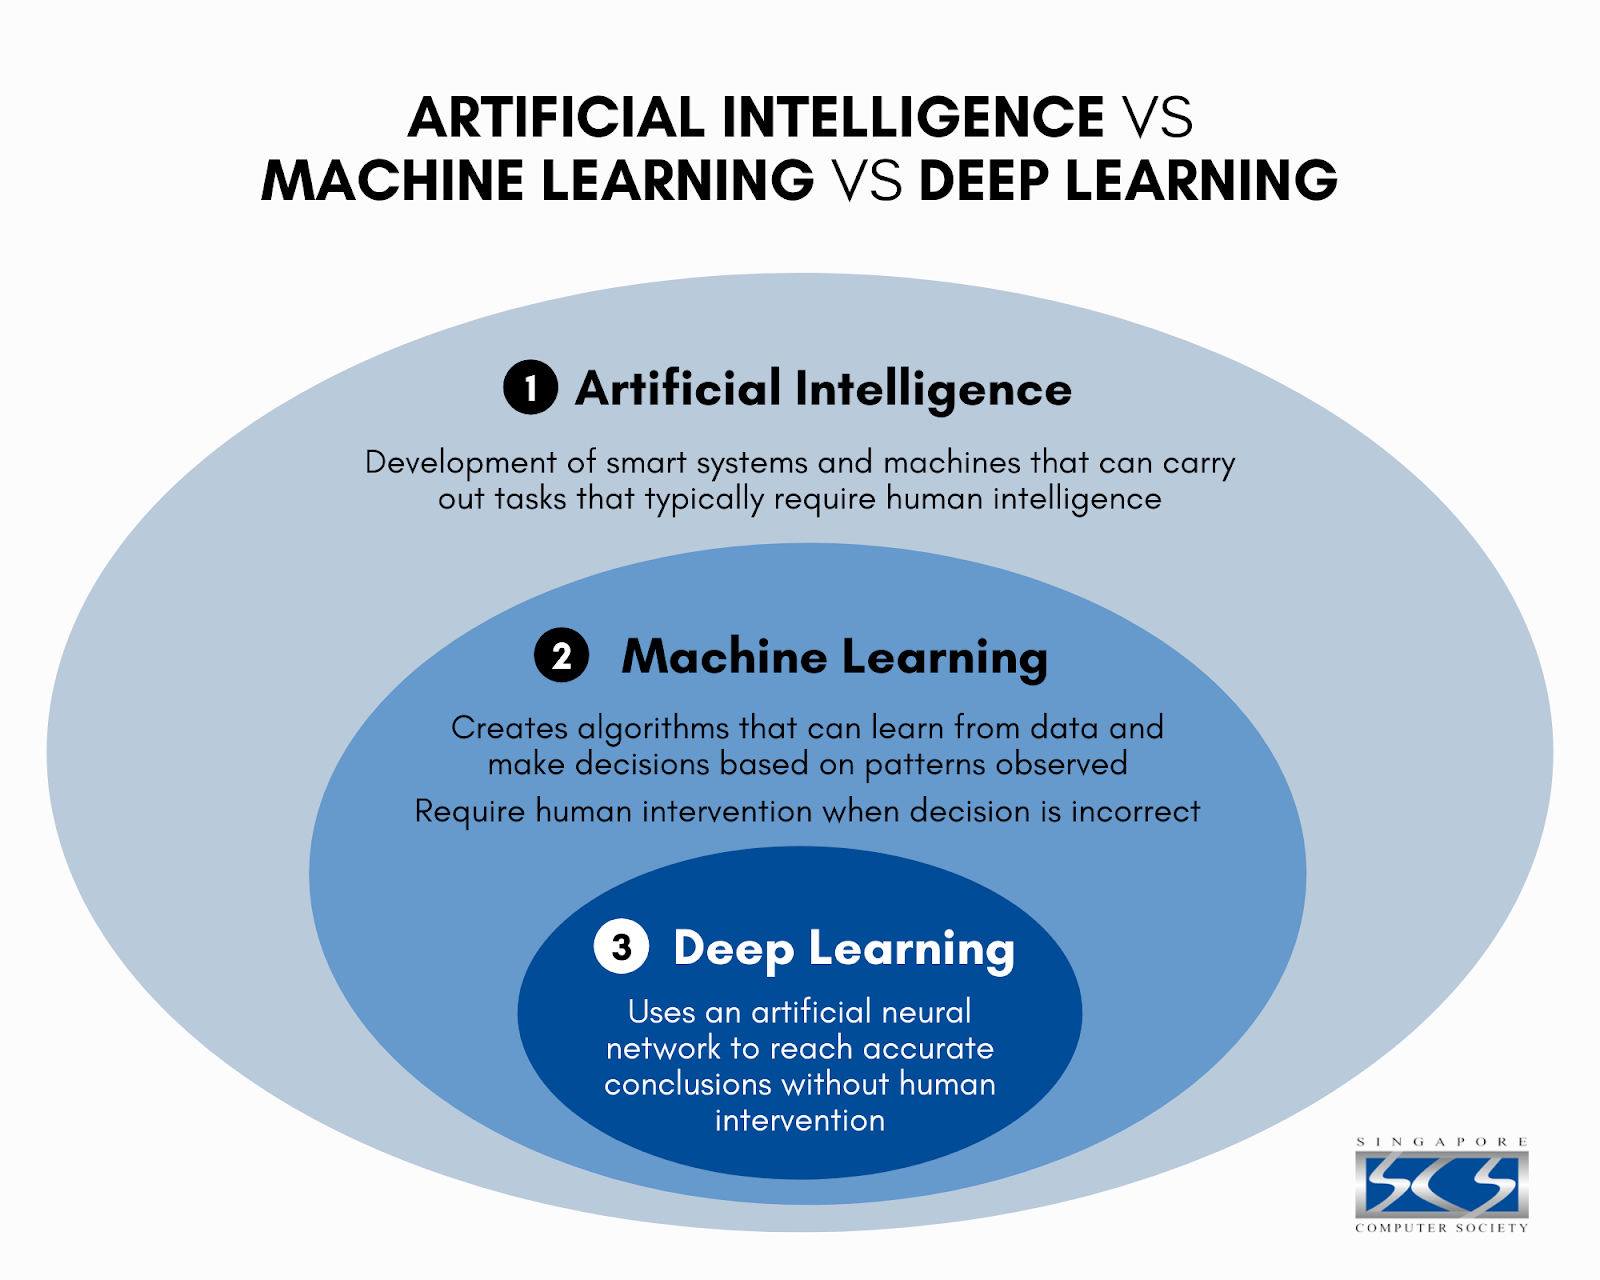
Machine Learning (ML) සහ Deep Learning (DL) කියන්නේ වර්තමාන තොරතුරු තාක්ෂණ ක්ෂේත්රය තුළ නිතරම කතාබහට ලක්වෙන, නමුත් බොහෝ දෙනෙකුට පැහැදිලි අවබෝධයක් නොමැති සංකල්ප දෙකක්. කෙනෙක් අලුතින්ම AI ක්ෂේත්රයට ප්රවේශ වෙද්දී මතු වෙන ප්රධානම ගැටලුවක් තමයි, "සාම්ප්රදායික Machine learning ක්රමවේදයන් සහ නවීන Deep Learning ක්රමවේදයන් අතර ඇති ප්රායෝගික වෙනස කුමක්ද?" යන්න. විශේෂයෙන්ම Text Analysis (පෙළ විශ්ලේෂණය) වැනි කාර්යයකදී මෙම වෙනස ඉතාම පැහැදිලිව හඳුනාගන්න පුළුවන්.
මේ වෙනස ප්රායෝගිකව අත්හදා බලන්න පුලුවන් විදිහට මම නිර්මාණය කරපු Open-source GitHub repository එකක් තමයි SimpleNN කියන්නේ. මේ ප්රොජෙක්ට් එක මම විශේෂයෙන්ම නිර්මාණය කළේ Sentiment Analysis (ලබා දී ඇති වාක්යයක් ධනාත්මකද සෘණාත්මකද යන්න හඳුනාගැනීම) සඳහා ML සහ DL භාවිතා වෙන ආකාරය සරලව පැහැදිලි කිරීමටයි.
අපි දැන් බලමු මේ ප්රොජෙක්ට් එක ඇතුළේ මොනවද තියෙන්නේ සහ එයින් අපිට ඉගෙන ගන්න පුළුවන් මොනවද කියලා.
එකම ප්රශ්නයට විසඳුම් දෙකක්: ML vs. Deep Learning
මෙහි ප්රධාන අරමුණ වෙන්නේ, එකම දත්ත කට්ටලයක් (Dataset) මත ක්රමවේද දෙකක් යටතේ Sentiment Classification සිදුකරන ආකාරය පෙන්වා දීමයි.
1. සාම්ප්රදායික Machine Learning ප්රවේශය
ඔබ ප්රොජෙක්ට් එකේ ඇති sentiment_classifier_nb.py ගොනුව පරීක්ෂා කළහොත්, එහි භාවිතා කර ඇත්තේ සාම්ප්රදායික ML ක්රමවේදයක් බව පෙනේවි. මෙහිදී Scikit-learn පුස්තකාලය භාවිතා කර වාක්යයක ඇති වචන සංඛ්යාත්මක දත්ත (Numerical data) බවට පත් කරන්නේ TF-IDF (Term Frequency-Inverse Document Frequency) තාක්ෂණය හරහායි. එයින් අදහස් වන්නේ යම්කිසි වචනයක් සමස්ත ලේඛනයට සාපේක්ෂව කොතරම් වැදගත්ද යන්න ගණනය කිරීමයි.
ඉන්පසුව Multinomial Naive Bayes නම් සම්භාවිතාව (Probability) මත පදනම් වූ ඇල්ගොරිතමය හරහා අදාළ වාක්යය Positive ද Negative ද යන්න තීරණය කරනු ලබනවා.
- මෙහි ප්රධාන වාසිය: මෙම ක්රමය ගණනය කිරීම් අතින් ඉතාමත් සැහැල්ලු සහ වේගවත්. එමෙන්ම අදාළ තීරණයට එළඹුණේ කුමන වචන මත පදනම්වද යන්න පැහැදිලිව නිරීක්ෂණය කිරීමට (Interpretable) හැකි වීම.
2. නවීන Deep Learning ප්රවේශය
අනෙක් අතට sentiment_classifier_nn.ipynb කියන Jupyter Notebook එක නිර්මාණය කර තිබෙන්නේ TensorFlow / Keras භාවිතා කර ගොඩනැගූ Neural Network එකක් හරහායි.
මෙහිදී වචන හඳුනාගන්නේ හුදෙක් සංඛ්යාතයක් (Frequency) විදිහට නෙවෙයි. Embedding Layer එකක් හරහා සෑම වචනයකටම 16-dimensional අවකාශයක (Vector space) නිශ්චිත ස්ථානයක් ලබා දෙනවා. ඉන්පසුව Global Average Pooling සහ Dense Layers (ReLU සහ Sigmoid activation සමගින්) හරහා දත්ත විශ්ලේෂණය කර අවසාන තීරණය ලබාදීම සිදු වෙනවා.
- මෙහි ප්රධාන වාසිය: මේ ක්රමයට වචන වල හුදු තේරුම පමණක් නොව, වාක්යයේ වචන පෙළගැසී ඇති රටාව සහ සැඟවුණු අර්ථයන් (Semantic meanings and contextual sequences) තේරුම් ගැනීමේ හැකියාවක් පවතිනවා.

පහත Interactive widget එකෙන් Layers ගණන වෙනස් කරලා Neural Network Architecture එක සජීවීව නරඹන්න ඔබට පුළුවන්:
කුමන ක්රමවේදය වඩාත් සුදුසුද?
පහත වගුවෙන් මේ ක්රම දෙකෙහි ප්රධාන තාක්ෂණික ලක්ෂණ සාරාංශ කර දක්වා තිබෙනවා. ඔබගේ මීළඟ AI ව්යාපෘතියට වඩාත් සුදුසු ක්රමය තීරණය කිරීමට මෙය උපකාරී වේවි.
| ලක්ෂණය | Machine Learning (Naive Bayes) | Deep Learning (Neural Network) |
|---|---|---|
| භාවිතා වන තාක්ෂණය | scikit-learn, numpy | tensorflow, keras, numpy |
| දත්ත සකසන ක්රමය | TF-IDF Vectorization | Word Embeddings (16-D vector space) |
| වේගය / සම්පත් | ඉතා වේගවත්, අඩු පරිගණක සම්පත් | පුහුණු කිරීමට වැඩි කාලයක් සහ සම්පත් ගනී |
| අවබෝධය (Context) | වචනවල සංඛ්යාතය පමණක් සලකයි | වචන වල සැබෑ අර්ථය (Semantics) තේරුම් ගනී |
| ප්රතිදානය (Output) | පැහැදිලි සම්භාවිතා අගයක් (Probability) | 0.0 සිට 1.0 දක්වා (Sigmoid) පරාසයක් |
මොඩලය පුහුණු කිරීම සහ දත්ත (Training & Dataset)
මෙම මොඩල ද්විත්වයම පුහුණු කර තිබෙන්නේ සැබෑ ලෝකයේ පාරිභෝගික ප්රතිචාර (Customer feedback) නියෝජනය කරන Review 100 කින් යුත් කුඩා දත්ත කට්ටලයක් (Dataset) භාවිතයෙනි. මෙහි ධනාත්මක ප්රතිචාර 50ක් සහ සෘණාත්මක ප්රතිචාර 50ක් සමබරව (Balanced) අඩංගු වෙනවා.
- Positive Example: "Exceeded my expectations in every way"
- Negative Example: "Broke within the first five minutes of use"

ඉහත ප්රස්ථාරය නිරීක්ෂණය කළහොත්, Neural Network ආකෘතිය Epochs ගණනාවක් පුරා දත්ත වලින් ඉගෙන ගනිමින්, තමන්ගේ Loss අගය ක්රමානුකූලව අඩු කරගන්නා ආකාරය මනාවට පැහැදිලි වෙනවා. අවසානයේදී පුහුණු කළ මොඩලය sentiment_model.keras ලෙසත්, වචන හඳුනාගන්නා Tokenizer එක tokenizer.json ලෙසත් සුරක්ෂිත වෙනවා.
ඔබේ පරිගණකයේ මෙය ධාවනය කරන්නේ කෙසේද?
මෙය න්යායාත්මකව ඉගෙන ගන්නවාට වඩා, ප්රායෝගිකව ධාවනය කර බැලීමෙන් ඔබට වැඩි අවබෝධයක් ලබාගත හැකියි. ඒ සඳහා පහත පියවර අනුගමනය කරන්න.
1. අවශ්ය Libraries Install කරගන්න:
pip install tensorflow scikit-learn numpy jupyter
2. Naive Bayes Classifier එක ධාවනය කිරීම: Terminal එකේ පහත විධානය ලබා දෙන්න. මෙය ක්ෂණිකව ක්රියාත්මක වී ප්රතිඵල ලබා දේවි.
python sentiment_classifier_nb.py
3. Neural Network එක ධාවනය කිරීම: Jupyter Notebook හරහා ඩීප් ලර්නිං ක්රියාවලිය පියවරෙන් පියවර අධ්යයනය කරන්න.
jupyter notebook
ඉන්පසු බ්රවුසරයෙන් sentiment_classifier_nn.ipynb ගොනුව විවෘත කර එහි ඇති සෙල් (cells) පිළිවෙලින් ක්රියාත්මක (Run) කරන්න.
👉 SimpleNN Repository එක මෙතනින් ලබාගන්න: https://github.com/sh4lu-z/SimpleNN
(ඔබටත් මෙවැනි ව්යාපෘති අත්හදා බලන්න උනන්දුවක් තියෙනවද? ඔබේ අදහස පහළින් Comment කරන්න!)